14 Soluciones Populares de Web Scraping en la Nube
Compara 14 opciones de scraping cloud por dificultad, escala, coste, integración y mantenimiento, con criterios prácticos para elegir.
El web scraping en la nube no es un único tipo de producto. Incluye plataformas donde configuras flujos completos, APIs que devuelven HTML, servicios con infraestructura de proxies, herramientas visuales sin código y bibliotecas que tú mismo alojas. Por eso, la mejor opción depende del sitio objetivo, el volumen, el nivel de JavaScript, el formato de salida y cuánto mantenimiento quieres asumir.
Esta guía reúne 14 soluciones populares y las ordena por categoría, no por una prueba de laboratorio. No existe en el dossier una medición independiente y uniforme de éxito, velocidad o coste total. Usa la lista para crear una selección corta y valida cada candidato con una tarea real, respetando los términos del sitio, la privacidad y la normativa aplicable.
Respuesta rápida: cómo elegir
| Necesidad | Tipo que suele encajar | Opciones para investigar |
|---|---|---|
| Flujos alojados, programación y almacenamiento | Plataforma cloud configurable | Apify |
| Interfaz visual y plantillas | Herramienta no-code | Octoparse, ParseHub |
| HTML o datos mediante una API | API gestionada | ScraperAPI, ScrapingBee, Zyte, Firecrawl, Scrape.do, ZenRows |
| Proxies y acceso a escala | Proveedor de infraestructura | Bright Data, Oxylabs, Decodo, IPRoyal |
| Control total del navegador | Biblioteca autogestionada | Playwright |
Compara siempre una tarea concreta: número de páginas, necesidad de JavaScript, concurrencia, proxy o renderizado, formato de salida y frecuencia. El precio de entrada rara vez es el coste completo.
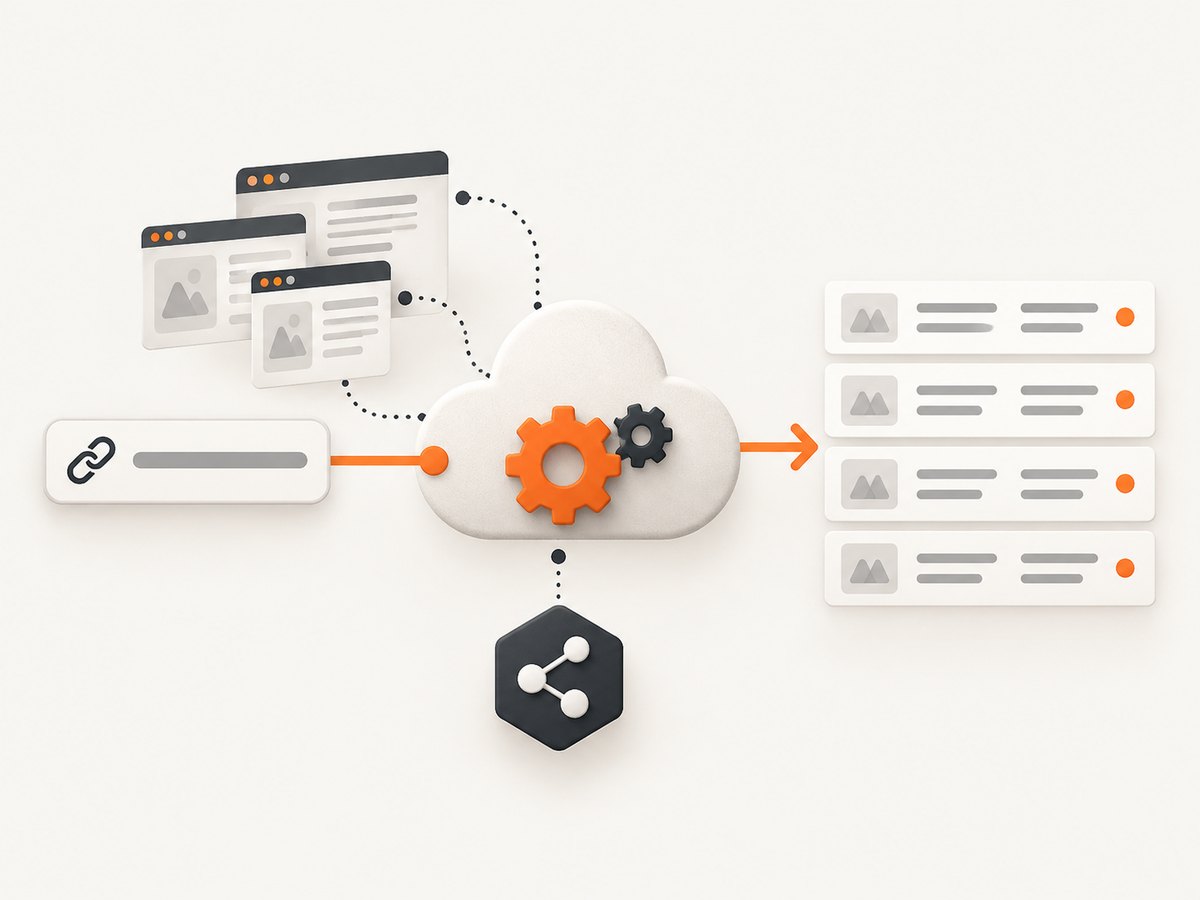
Las 14 soluciones
1. Apify: plataforma para flujos alojados
Apify es una plataforma de scraping y automatización cloud. Su modelo encaja cuando quieres ejecutar tareas programadas, guardar resultados y reutilizar actores o flujos sin operar toda la infraestructura. La página oficial consultada mostraba planes Free, Starter, Scale y Business; Starter figuraba a 19 USD/mes, Scale a 199 USD/mes y Business a 999 USD/mes, además del consumo. El nivel gratuito incluía 5 USD para gastar en la plataforma o en Actors y se mostraba un precio de 0,20 USD por unidad de cómputo. Son cifras consultadas el 30 de septiembre de 2026; comprueba la página de precios de Apify antes de contratar.
Evalúa por separado el coste de la plataforma y el del actor concreto. Revisa concurrencia, almacenamiento, retención de resultados, programación y mantenimiento del extractor cuando cambie el sitio. Apify confirma una categoría de socios afiliados, pero no des por supuestas comisiones, plazos ni condiciones sin verificarlas.
2. Bright Data: APIs y herramientas con infraestructura de red
Bright Data aparece en comparativas de APIs y herramientas de web data. Su propuesta pertenece a la categoría de servicios que combinan acceso programático con infraestructura de proxies y productos para recopilar datos. Antes de elegirlo, confirma qué parte del precio corresponde a solicitudes, tráfico, tipo de proxy, renderizado o funciones adicionales. La dificultad de un dominio concreto puede cambiar el coste y la tasa de éxito.
3. Oxylabs: proveedor orientado a datos y proxies
Oxylabs se cita como proveedor de herramientas de scraping y acceso proxy. Es una opción para equipos que necesitan integrar una API o gestionar infraestructura de red a escala. Revisa el producto exacto, las ubicaciones disponibles, la política de uso, la concurrencia y si el contenido JavaScript requiere un servicio de navegador separado. Sus comparativas son una fuente para descubrir candidatos, no una prueba neutral de rendimiento.
4. Octoparse: extracción visual con ejecución cloud
Octoparse está orientado a usuarios que prefieren configurar tareas visualmente. Su página oficial describía un plan Standard desde 69 USD/mes, hasta 100 tareas, extracción cloud con hasta tres procesos concurrentes, plantillas, rotación IP, proxies residenciales, resolución automática de CAPTCHA, exportación, programación y acceso a Data Export API. Precio y prestaciones consultados el 30 de septiembre de 2026: confirma límites, facturación y disponibilidad regional en la página oficial de precios.
Una interfaz visual reduce el código inicial, pero no elimina el mantenimiento. Prueba selectores cuando cambie el diseño, controla duplicados y define qué ocurre si una tarea queda a medias.
5. ParseHub: flujos visuales para sitios con interacción
ParseHub es otra alternativa visual para seleccionar elementos y construir flujos. Tiene sentido cuando el equipo necesita interactuar con páginas sin desarrollar un crawler completo. Valida en tu caso el soporte para paginación, clics, sesiones, exportación, frecuencia de ejecución y límites del plan. No asumas que una tarea visual atravesará controles de acceso o que todos los sitios permiten automatización.
6. ScraperAPI: API gestionada para obtener páginas
ScraperAPI aparece entre las APIs de scraping cloud. El patrón de integración es sencillo: tu aplicación envía una URL y recibe contenido para procesarlo. Antes de contratar, comprueba si el plan incluye renderizado JavaScript, qué cuenta como solicitud, límites de concurrencia, códigos de error, reintentos y regiones. Calcula el coste con tu proporción real de páginas estáticas y dinámicas.
7. ScrapingBee: API con opciones de navegador
ScrapingBee se presenta en comparativas como una API para automatizar la obtención de páginas, incluidas las que necesitan navegador. Confirma en su documentación actual las opciones de JavaScript, proxies, espera, cabeceras y formatos de respuesta. Un endpoint que funciona para una página pública puede necesitar otra configuración para una aplicación con sesión o contenido cargado después de la primera respuesta.
8. Zyte: servicios para extracción y acceso web
Zyte es otra solución gestionada citada en el dossier. Considera si necesitas una API de acceso, extracción estructurada o un flujo más amplio de procesamiento. Revisa cómo se facturan solicitudes, navegador, proxies, almacenamiento y soporte. Documenta un conjunto de URLs representativas antes de estimar el coste mensual.
9. Firecrawl: convertir páginas en contenido utilizable
Firecrawl aparece como servicio de scraping y rastreo para equipos que quieren integrar páginas en aplicaciones y flujos de datos. Comprueba qué formatos entrega, cómo trata contenido dinámico, límites de rastreo, exclusiones de dominio, webhooks y retención. Si tu objetivo es alimentar búsqueda o modelos, mide también la calidad de limpieza y la estabilidad de los campos, no solo la descarga.
10. Scrape.do: API de scraping cloud
Scrape.do figura entre las APIs orientadas a simplificar el acceso a páginas. Analiza el número de solicitudes, concurrencia, países o tipos de proxy incluidos y el tratamiento de errores. Usa una muestra con respuestas 200, redirecciones, páginas vacías y bloqueos para conocer el comportamiento real de tu caso.
11. ZenRows: API para sitios con más fricción
ZenRows aparece en comparativas de APIs de scraping. Es candidato para equipos que prefieren delegar parte de la gestión de navegador y red. Verifica qué controles anti-bot, JavaScript, proxy y extracción están disponibles en el producto y plan elegidos. No presentes ninguna herramienta como garantía universal contra defensas: el resultado depende del sitio y de sus reglas.
12. Decodo: infraestructura proxy para recopilación
Decodo se incluye entre los proveedores de proxies y herramientas de web data. Puede encajar si tu arquitectura ya tiene un crawler y necesitas una capa de acceso. Calcula el coste por tráfico o solicitudes, las ubicaciones, la rotación y el soporte para el protocolo que utilices. Asegúrate de que tu uso cumple la legislación y las condiciones del sitio de destino.
13. IPRoyal: proxies para tu propio crawler
IPRoyal es otra alternativa de infraestructura proxy citada en el dossier. La responsabilidad del navegador, los selectores, los reintentos y el almacenamiento permanece en tu aplicación. Eso puede dar control y flexibilidad, pero también significa que debes monitorizar cambios, bloqueos, fugas de sesión y consumo de ancho de banda.
14. Playwright: alternativa técnica autogestionada
Playwright es una biblioteca de automatización de navegador, no un servicio cloud listo para usar. Es adecuada cuando necesitas controlar Chromium, Firefox o WebKit desde tu propia infraestructura y aceptar el trabajo operativo: imágenes Docker, colas, concurrencia, proxies, límites, capturas, reintentos y observabilidad.
import { chromium } from 'playwright';

const browser = await chromium.launch();
const page = await browser.newPage({ viewport: { width: 1440, height: 900 } });
await page.goto('https://example.com', { waitUntil: 'networkidle' });
const title = await page.title();
const html = await page.content();
console.log({ title, bytes: Buffer.byteLength(html) });
await browser.close();
Este ejemplo descarga HTML, pero no resuelve por sí solo consentimiento, CAPTCHAs, límites legales, almacenamiento ni escalado. Añade selectores explícitos, tiempos máximos, registro de URL y estado, y un mecanismo para no repetir páginas ya procesadas.
Marco de decisión paso a paso
- Define la salida. Decide si necesitas HTML, texto limpio, campos estructurados, imágenes o PDF.
- Clasifica el sitio. Anota JavaScript, login, paginación, geolocalización, consentimiento, rate limits y cambios frecuentes.
- Calcula unidades. Multiplica páginas por frecuencia y añade reintentos, renderizado, tráfico y almacenamiento.
- Elige el modelo operativo. Una plataforma alojada reduce infraestructura; una API encaja con tu backend; Playwright ofrece control a cambio de mantenimiento.
- Prueba una muestra. Incluye páginas rápidas, lentas, vacías, con redirección y con contenido que aparece tras un clic.
- Revisa permiso y retención. Documenta términos del sitio, datos personales, base legal, conservación y controles de acceso.
Implementación mínima y robusta
Para una API gestionada, registra la URL, el código HTTP, el tiempo, el tamaño, el proveedor y el motivo de cada reintento. Usa límites de tiempo y backoff con jitter. Separa errores transitorios de respuestas definitivas y guarda una huella del contenido para detectar cambios.
import requests, time, random

url = 'https://example.com'
for attempt in range(4):
    try:
        response = requests.get(url, timeout=30, headers={'User-Agent': 'research-bot/1.0'})
        response.raise_for_status()
        print(response.text[:200])
        break
    except requests.RequestException as exc:
        if attempt == 3:
            raise
        time.sleep((2 ** attempt) + random.random())
Errores frecuentes y soluciones
| Síntoma | Causa probable | Corrección |
|---|---|---|
| HTML vacío | El contenido se genera con JavaScript | Usa renderizado de navegador, espera un selector y limita el tiempo de espera. |
| 403 o 429 | Reglas del sitio o demasiadas solicitudes | Reduce concurrencia, respeta robots y términos, aplica backoff y revisa si tienes autorización. |
| Selectores rotos | Cambió el diseño | Prefiere atributos estables, pruebas de contrato y alertas por ausencia de campos. |
| Duplicados | Reintentos sin idempotencia o paginación repetida | Usa una clave canónica de URL y una huella de contenido. |
| Coste inesperado | Renderizado, proxy, tráfico o reintentos no previstos | Etiqueta cada tarea, fija límites y calcula el coste por página válida. |
| Sesiones mezcladas | Cookies compartidas entre trabajos | Aísla contextos, almacena secretos fuera del código y elimina sesiones al terminar. |
Rendimiento, fiabilidad y coste
La concurrencia aumenta el rendimiento hasta que el sitio, el proveedor o tu propia cola se convierte en cuello de botella. Empieza con un nivel pequeño y observa latencia, errores, memoria y coste. Cachea respuestas cuando el contenido no cambia con frecuencia; evita volver a descargar páginas idénticas.
La fiabilidad requiere reintentos limitados, colas durables, checkpoints y alertas. Guarda el estado por URL para reanudar una ejecución interrumpida. Para datos críticos, conserva la respuesta original junto con la versión normalizada y la fecha de captura.
Compara proveedores por coste de una unidad útil, no por el precio anunciado. Una página que necesita navegador, proxy residencial y varios reintentos puede costar mucho más que una página HTML estática. Revisa también almacenamiento, exportación, retención y soporte.
Or skip the browser setup
Si solo necesitas una captura limpia de una página para documentación, control visual o un flujo de IA, ScreenshotNeo ofrece una API y un servidor MCP. Antes de capturar acepta el banner de cookies y elimina más de 60 plataformas de consentimiento, popups de newsletter y widgets de chat; cada paso puede desactivarse. Solo cobra capturas limpias: comprobaciones de bot o CAPTCHA, páginas en blanco, timeouts, cargas fallidas y aciertos de caché no se facturan, y la respuesta indica el veredicto mediante las cabeceras X-Page-Verdict y X-Billed.
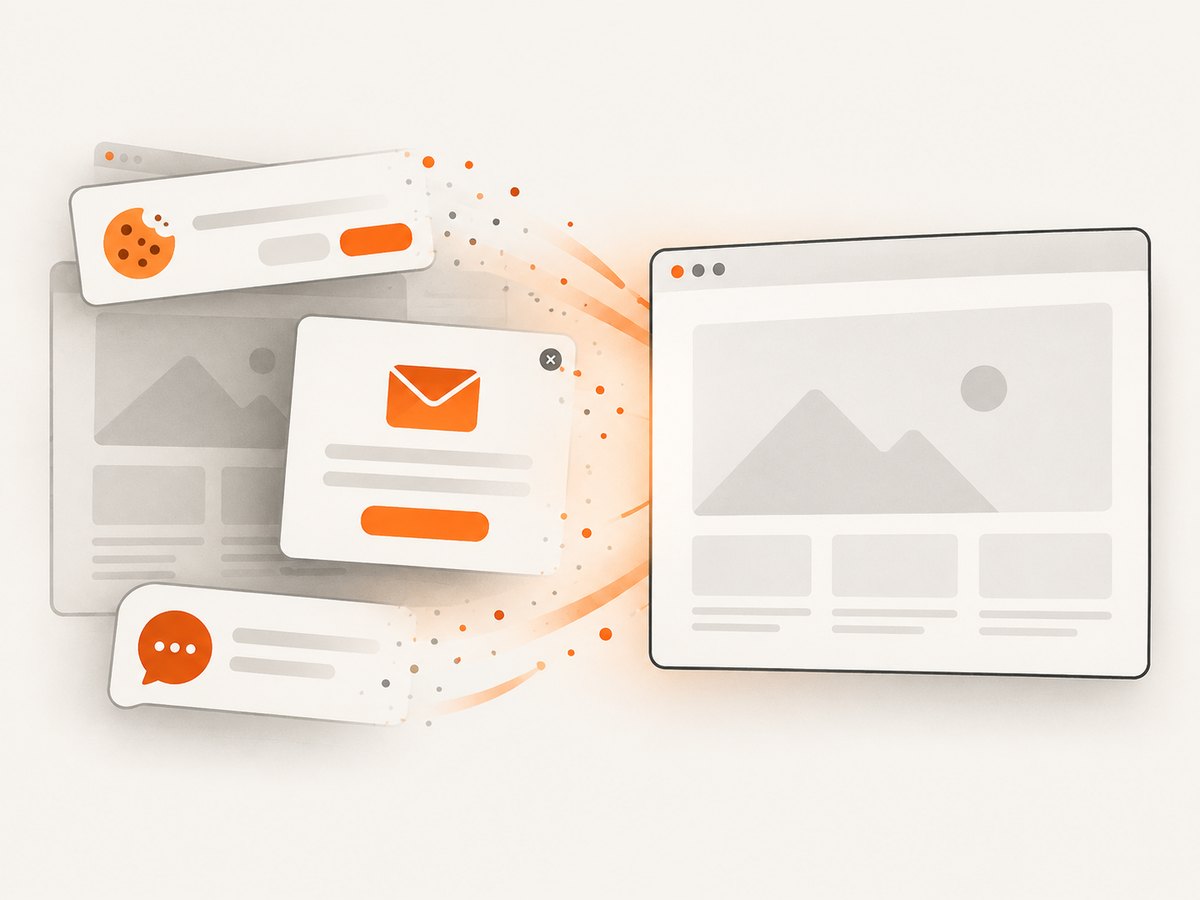
La llamada básica es:
curl -G "https://api.screenshotneo.com/v1/shot" -d access_key=YOUR_API_KEY --data-urlencode url=https://stripe.com -o shot.webpConsulta los parámetros y opciones en la documentación de ScreenshotNeo. También puedes usar Python:
import requests
r = requests.get("https://api.screenshotneo.com/v1/shot", params={"access_key": "YOUR_API_KEY", "url": "https://stripe.com"}, timeout=90)
open("shot.webp", "wb").write(r.content)
Y Node.js:
const q = new URLSearchParams({ access_key: 'YOUR_API_KEY', url: 'https://stripe.com' });
const res = await fetch(`https://api.screenshotneo.com/v1/shot?${q}`);
Incluye captura de página completa con imágenes lazy cargadas, selector CSS, modo oscuro, 12 dispositivos y cualquier viewport, escala retina, PDF con tamaño, márgenes, orientación y rangos, HTML/CSS a imagen, CSS y JavaScript personalizados, clic previo, selectores ocultos, esperas, bloqueo de anuncios, trackers, solicitudes o tipos de recurso, cabeceras, cookies, user agent, Authorization, zona horaria, geolocalización, fondo transparente, redimensionado, caché con TTL, enlaces firmados, trabajos asíncronos con webhooks, lotes de 100 URLs, API de uso y OpenAPI. Los nombres de parámetros habituales de otras APIs también funcionan.
Un servidor MCP permite que Claude, Cursor u otro cliente MCP use take_screenshot, get_page_info y capture_pdf. El plan gratuito incluye 1.000 capturas al mes sin tarjeta; los planes de pago empiezan en 5 USD por 3.000 capturas. Crea una cuenta gratuita de ScreenshotNeo.
Preguntas frecuentes
¿Cloud scraping significa que no necesito código?
No siempre. Las herramientas visuales reducen el código inicial, mientras que las APIs requieren integración y Playwright requiere operar tu propia infraestructura.
¿Qué opción sirve para cualquier sitio?
Ninguna. JavaScript, sesiones, límites, consentimiento y defensas cambian por dominio. Prueba una muestra y respeta las reglas aplicables.
¿Cómo comparo dos precios?
Calcula el coste de una página válida incluyendo solicitudes, renderizado, proxies, reintentos, almacenamiento y exportación.
¿Cuándo conviene Playwright?
Cuando necesitas control detallado del navegador y puedes mantener colas, imágenes, proxies, observabilidad y actualizaciones.
¿Puedo usar ScreenshotNeo para extraer datos?
ScreenshotNeo está orientado a capturas, información de página y PDF. Para extracción estructurada, usa una herramienta del listado que entregue los campos que necesitas.


